В DigitalOcean объяснили, как пакетный вывод снижает затраты на ИИ до 50%
В DigitalOcean объяснили, как пакетный вывод снижает затраты на ИИ до 50%. Фото: из архива компании
Как отмечается, типичные объёмы работы — обращения в поддержку за прошлую неделю, каталог из 50 тысяч товаров или накопившиеся контракты на резюмирование — объединяет одно: ни один из этих запросов не требует ответа за две секунды, но при прогоне через те же real-time эндпоинты, что и живой трафик, за каждый платится по ставке живого трафика, и на фоне прогноза Gartner о 2,7 трлн $ мировых расходов на ИИ в 2026 году и просьб предприятий помочь управлять затратами пакетный вывод закрывает именно этот разрыв.
На DigitalOcean пакетные запросы к моделям OpenAI и Anthropic стоят до 50% меньше ставок реального времени и используют лимиты, отдельные от продакшен-трафика. Пакетный вывод подходит для работы, где результаты могут подождать, — извлечение данных из документов, сортировка обращений, оценки, — но не годится для интерактивных функций и задач, требующих результата за минуты; сервис работает на Inference Engine, поддерживает текстовые модели OpenAI и Anthropic, а модели с открытыми весами пока не поддерживаются.
Пакетный вывод, также называемый офлайн- или асинхронным, отличается от real-time тем, что обрабатывает тысячи запросов параллельно, и никто не ждёт ответа на каждый отдельный запрос: результаты доступны по завершении задачи в пределах 24-часового окна, стоимость запроса до 50% ниже, лимиты отдельные, результаты приходят файлом с результатами и отдельным файлом ошибок, хранящимися до 30 дней, а лучшими сценариями являются массовое извлечение, классификация, обогащение и оценки.
Рабочий процесс состоит из пяти шагов: собрать входные данные в формате JSON Lines с уникальным ID для каждого запроса, отправить их одной задачей с указанием окна завершения, дождаться проверки файла и постановки в очередь с обработкой по мере наличия мощностей, просмотреть результаты и файл ошибок, а затем скачать файлы и сопоставить каждую строку с входом по ID.
Пакетный вывод при этом не заменяет непрерывное пакетирование (continuous batching) — технику планирования внутри движка обслуживания модели, которая добавляет и убирает запросы из работающего пакета на каждом шаге декодирования, — поскольку провайдер может применять её как для реального, так и для пакетного трафика.
Среди преимуществ — более низкая стоимость, поскольку оплачиваются только завершённые запросы и необработанная работа из неудачной или истёкшей задачи не попадает в счёт; более высокая пропускная способность без проблем с лимитами, так как пакетные задачи используют отдельные лимиты и не вытесняют эндпоинты, от которых зависят пользователи; более простая эксплуатация, поскольку платформа до двух раз повторяет временные ошибки (429, 408 и 5xx) и один сбойный запрос не проваливает всю задачу, а ошибки пишутся в отдельный файл; оптимизированное использование ресурсов за счёт более низкого приоритета планирования на общих GPU-мощностях в непиковые часы; и доступная оценка в масштабе, когда тысячи тестовых случаев прогоняются против нового промпта или модели одной задачей.
Среди сценариев применения — обработка документов и извлечение данных.
Разработчик Дамки де Вилде с помощью Batch API OpenAI обработал около 60 тыс. вакансий на selectfrom.work, «вытащив» из каждой резюме, зарплату, технологии и тип занятости, причём полный прогон обошёлся примерно в 10 $, а пакеты часто завершались за 10–15 минут вместо запланированных 24 часов.
Еще одивариант применения - классификация и сортировка обращений в поддержку: инженеры DigitalOcean прогнали эту задачу на 250 тыс. реальных потребительских жалоб, размечая каждую по продуктовой линейке, оценивая тональность и срочность, извлекая сущности и готовя резюме, и все 250 тыс. запросов выполнились за семь пакетных задач.
При этом крупнейшие задачи на 40 тыс. запросов завершались за 1,4–2,2 часа, а расчётная стоимость составила 7,04 $ против 14,07 $ за те же токены по бессерверным ставкам, при этом более дешёвая GPT-5 Nano согласилась с собственными метками набора данных в 83,6% случаев, а Claude Haiku 4.5 достигла 84,9% примерно при 35-кратной расчётной стоимости, поэтому пакетные метки стоит считать сильным первым проходом с проверкой человеком там, где срочность или категория определяют решение.
Следующий пример - модерация накопившегося контента, которую можно провести за ночь, не конкурируя с живым эндпоинтом за лимиты; обогащение каталога, как в Instacart, где сервис Maple отправляет миллионы промптов через пакетный API провайдера; и оценка моделей с генерацией синтетических данных, для чего фреймворк Inspect UK AI Security Institute поддерживает флаг --batch, а разработчик Джеймс Перальта сократил расходы на оценку вдвое через Batch API OpenAI.
При этом DigitalOcean 12 октября 2026 года запустила Agent Learning and Data Services: Signals указывает, где агент не дотягивает, а Evaluations и Simulations проверяют изменение до того, как его увидят клиенты, причём Simulations идут как живые сессии агента, а не через пакетный вывод.
Решать, использовать ли пакетный вывод, предлагается с одного вопроса: ждёт ли человек или агент этого ответа, и если вывод идёт в базу данных, отчёт или обучающий набор, а не на экран, пакетный вывод стоит рассмотреть — в частности, для фиксированной груды уже существующих входных данных, для бэкфилла, упирающегося в лимиты живых эндпоинтов, для неинтерактивной работы, доминирующей в счёте за вывод, и для тестового набора перед сменой промпта или модели, тогда как чат, поиск и агентные циклы должны оставаться на Serverless или Dedicated Inference.
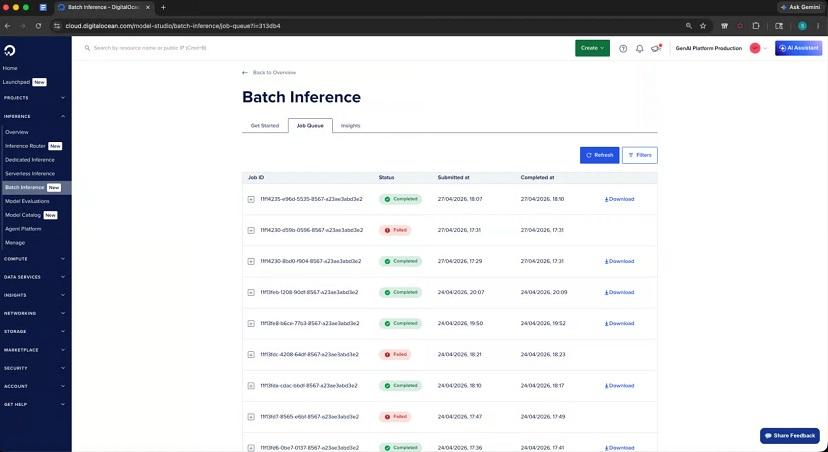
Сам сервис использует тот же API и ключ доступа к моделям, что и Serverless Inference, имеет 24-часовое окно завершения, по истечении которого задача истекает: завершённые запросы сохраняются и оплачиваются, незавершённые не оплачиваются, а остаток можно запустить продолжением; поддерживаются только текстовые промпты для коммерческих моделей OpenAI и Anthropic, входные файлы до 200 МБ и до 50 тысяч запросов на файл. Ключевые функции включают страницы Job Queue и Insights в панели управления со статусом, прогрессом и использованием, автоматические повторы временных ошибок до двух раз с экспоненциальной задержкой перед записью в файл ошибок, продолжение задачи только для сбойных или недостигнутых запросов и идемпотентное создание задачи, когда повтор с тем же request_id возвращает исходную задачу вместо дубликата.
Для запуска задачи предлагается создать ключ доступа к моделям с включённым пакетным выводом для текстовых моделей OpenAI и Anthropic, подготовить JSONL-файл с одним запросом на строку и уникальным custom_id в разных форматах для OpenAI и Anthropic, зарезервировать слот загрузки через POST /v1/batches/files и загрузить файл по presigned URL на DigitalOcean Spaces (URL истекает примерно через 15 минут), создать задачу через POST /v1/batches с file_id, провайдером, completion_window 24h и request_id для безопасных повторов (для OpenAI также требуется endpoint, для Anthropic — нет), отслеживать статус через GET /v1/batches/{batch_id} или вкладку Job Queue и скачать результаты через GET /v1/batches/{batch_id}/results, причём сбойные запросы приходят в отдельном файле ошибок. В статье приведён пример на PyDo, который пишет входной файл, загружает его, создаёт задачу, опрашивает до завершения и скачивает результаты, а также напоминается, что повторное использование request_id при повторе воспроизводит существующую задачу вместо создания дубликата, а задача-продолжение покрывает сбойные или недостигнутые запросы без повторной отправки всего файла.
В ответах на частые вопросы уточняется, что дешёвый способ пакетной обработки — перенести работу, которая может подождать, с real-time эндпоинтов в пакетный API; что DigitalOcean Batch Inference обрабатывает миллионы документов за ночь, если разбить их на JSONL-файлы до 50 тысяч запросов и отправлять каждый как задачу с 24-часовым окном; что DeepSeek в пакетном выводе на DigitalOcean недоступен, поскольку сервис охватывает только текстовые модели OpenAI и Anthropic, а DeepSeek можно запускать на Serverless Inference по ставкам реального времени; и что непрерывное пакетирование — это техника планирования внутри движка, отличная от пакетного вывода, хотя обе группируют запросы. В завершение подчёркивается, что сервис позволяет платить за используемый интеллект, а не по ставкам реального времени за работу, которая может подождать, и что стартап Traversal делает миллионы API-вызовов в месяц через платформу DigitalOcean AI Platform с доступностью около 99,96%.
Упомянутый сервис


Комментариев пока не было