Кэширование промптов стало общедоступным в DigitalOcean Serverless Inference
Кэширование промптов стало общедоступным в DigitalOcean Serverless Inference. Фото: из архива компании
Поводом для доработки стала особенность работы агентов — каждый новый вызов добавляет результат последнего вызова инструмента в конец контекста, где уже хранятся системный промпт, описания инструментов, прочитанные файлы и все предыдущие действия.
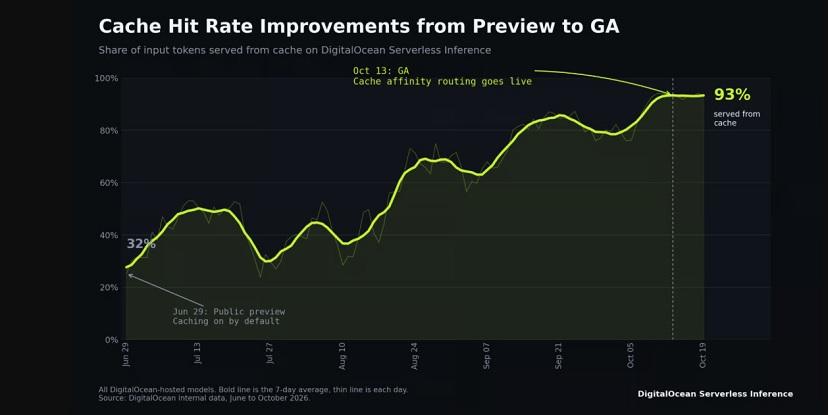
На платформе более 90% входных токенов, которые отправляют агенты, модель уже обрабатывала, однако скидка действовала только при попадании запроса на ту реплику, где хранится кэш. Без маршрутизации с учётом кэша повторный запрос уходил туда, куда его направлял балансировщик, и на чужой реплике приходилось платить полную цену за уже отправленные токены.
Решением стала привязка к кэшу: маршрутизатор для каждого запроса проверяет, какие реплики уже содержат большую часть его промпта, сужает выбор до этого «тёплого» набора и только затем распределяет нагрузку между наименее занятыми из них, а при отсутствии тёплых реплик возвращается к балансировке по всему пулу.
Идентификатор сессии управлять не нужно — второе сообщение разговора уже содержит первое, поэтому маршрутизатор сам находит совпадение. Во внутреннем тестировании на флагманских моделях привязка к кэшу подняла долю попаданий с примерно 30% до более чем 90%: у GLM-5.3 показатель вырос с единиц процентов до 88–95%, у Kimi K3 повторное использование префикса составляет от 84% на коротких промптах до 92% и выше на длинных.
В общедоступную версию добавили два управляющих параметра, увеличила контекстные окна и выпустила дашборд. Параметр prompt_cache_key позволяет разделять трафик внутри собственного аккаунта — например, держать кэш юридического отдела отдельно от маркетингового или изолировать данных разных конечных клиентов; запросы с разными ключами не делят кэш, при этом кэширование между аккаунтами изолировано по умолчанию. Кэширование теперь поддерживается и в Responses API, причём каждый ответ сообщает точное число кэшированных токенов, так что экономию можно проверить запрос за запросом. Контекстные окна выросли до 256 тысяч токенов и выше, чтобы в кэш помещалась большая часть длинной кодовой базы, документа или текущего разговора.
Новый дашборд в панели управления показывает долю попаданий в кэш во времени, разбивку по моделям и оценку сэкономленных денег, помогая находить промпты, которые не получают выгоды. Кэширование применяется автоматически ко всем подходящим запросам, включать ничего не нужно, а prompt_cache_key требуется лишь для группировки или изоляции трафика; неиспользованные кэшированные токены оплачиваются по стандартному тарифу входных, и каждый ответ точно сообщает, сколько токенов каждого типа было задействовано.
Упомянутый сервис


Комментариев пока не было