В DigitalOcean представили маршрутизатор вывода с учётом кэширования: самый дешёвый вариант не всегда оказывается лучшим
В DigitalOcean представили маршрутизатор вывода с учётом кэширования: самый дешёвый вариант не всегда оказывается лучшим. Фото: из архива компании
В апреле этого года компания уже запустила маршрутизацию с учётом предпочтений, которая подбирала модель под конкретную задачу, однако новый функционал выводит этот подход на принципиально иной уровень, рассматривая не отдельный запрос, а целую агентскую сессию.
Дело в том, что переключение на более дешёвую модель часто приводит к сбросу «тёплого» кэша, который содержит системные инструкции, определения инструментов и историю диалога, и тогда следующий вызов может оказаться дороже и медленнее, чем использование номинально более дорогой модели с сохранённым контекстом.
Проблема эта становится критичной для компаний, масштабирующих ИИ-решения, — генеральный директор Coinbase Брайан Армстронг недавно задал вопрос, как сохранить уровень расходов при экспоненциальном росте использования токенов, и эта боль знакома многим гигантам. Uber исчерпал годовой бюджет на ИИ-разработку за четыре месяца и ввёл ежемесячный лимит на сотрудника, Walmart ограничил количество токенов для внутреннего агента Code Puppy, а сотрудники Priceline сообщили, что плановое обновление Cursor обошлось в четыре-пять раз дороже ожидаемого. Кэширование, как показывают данные ведущих провайдеров, кардинально меняет экономику: Z.ai исходит из предположения о 90,9% попаданий в кэш для программистских задач, Anthropic сообщает, что Claude Code делает последовательные вызовы дешевле и быстрее за счёт кэширования, а OpenAI фиксирует снижение задержки до 80% для кэшированных запросов.
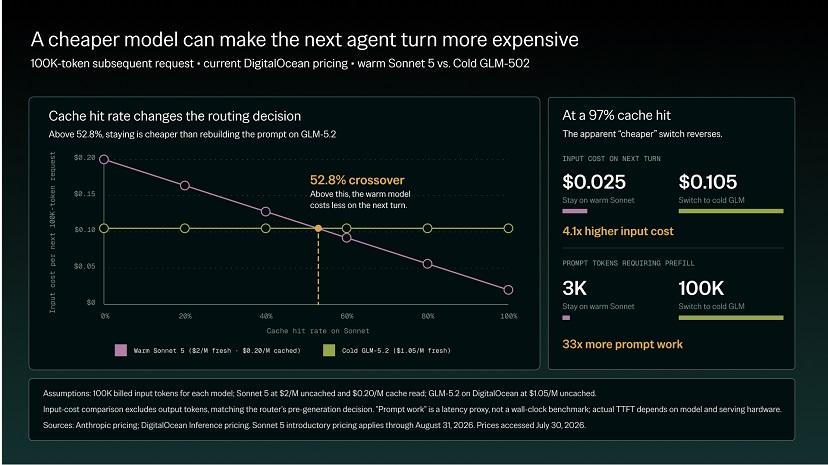
Чтобы наглядно проиллюстрировать эффект, разработчики приводят пример агента с 90 тыс. уже кэшированных токенов из 100 тыс. в контексте Claude Sonnet 5. При цене 2,5 $ за миллион некэшированных и 0,2 $ за миллион кэшированных входных токенов следующий запрос обойдётся примерно в 0,043 $ благодаря 90% попаданий.
Переключение на GLM-5.2 с его 0,7 $ за миллион некэшированных входных данных выглядит дешевле, но на деле заставляет обрабатывать все 100 тыс. токенов заново, и тот же запрос уже стоит 0,07 $, что в 1,6 раза дороже, а время до первого токена увеличивается в разы из-за необходимости полной предварительной обработки.
В ответ на запросы клиентов DigitalOcean внедрила два дополняющих механизма управления этим компромиссом. Первый — явное соответствие модели через HTTP-заголовок X-Model-Affinity, который позволяет приложениям, уже поддерживающим идентификаторы сессий, привязывать запросы к конкретной модели и сохранять кэш.
Второй — политика распределения бюджета маршрутизации, которая определяет, в каких случаях нарушение этого соответствия оправдано дополнительными затратами. Таким образом, новый маршрутизатор выходит за рамки простого выбора правильной модели на каждый момент и превращается в полноценный интеллектуальный слой, способный учитывать реальные паттерны работы команды и экономическую эффективность всей сессии, а не отдельного вызова.
Упомянутый сервис


Комментариев пока не было